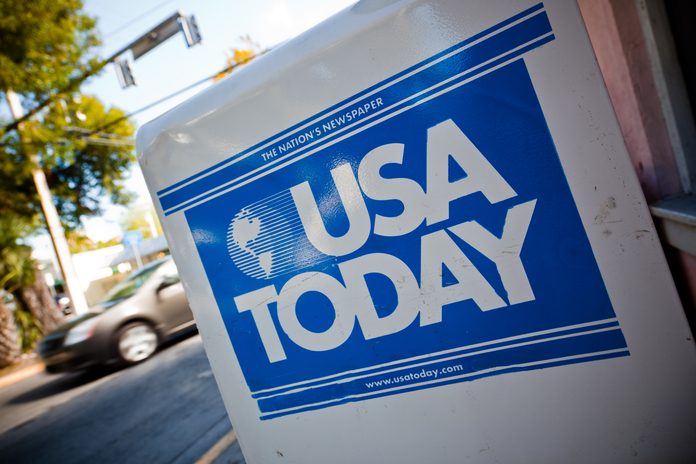
El periódico, junto con otros 19 diarios locales del mismo grupo, ha demandado a la compañía de inteligencia artificial ante un tribunal norteamericano por infringir sus derechos de autor. El grupo editorial acusa a OpenAI de utilizar sin permiso el contenido de cientos de miles de artículos de cabeceras como USA Today, The Tennessean, Indy Star, The Enquirer o Detroit Free Press, entre otros, para entrenar a su aplicación ChatGPT.
En la demanda, interpuesta ante el Tribunal Federal del Distrito Sur de Nueva York contra las entidades operativas, matrices y filiales de OpenAI, USA Today exige a la tecnológica más de 250 millones de dólares por daños y perjuicios. Además de dicha indemnización, la publicación ha solicitado una medida cautelar y la destrucción de los modelos que contengan el material periodístico presuntamente empleado.
Uso del contenido sin licencias ni retribución
Según la demandante, la compañía tecnológica recopiló, almacenó y procesó cientos de miles de noticias, reportajes y otras coberturas informativas de un total de 19 medios de comunicación afiliados, y lo hizo «sin contar con licencias previas ni pagar retribución comercial alguna», recoge Diario Constitucional. Este saqueo masivo de contenido habría servido, continúa USA Today, «como base fundamental» para desarrollar ChatGPT y sus modelos de IA generativa derivados.
El escrito de acusación también señala que OpenAI empleó programas diseñados para suprimir los metadatos de gestión de derechos de autor, borrando créditos de los redactores, titulares y reservas de protección legal. De esa manera, las respuestas ofrecidas por la IA generaron copias literales de los artículos, que sustituían y desviaban el tráfico de Internet, menoscabando la captación de lectores para las webs de los diarios.
Más de 160.000 artículos afectados
Los demandantes cifran en más de 160.000 las entradas del repositorio de datos usadas por la tecnológica para el adiestramiento de su chatbot, además de más de 122 millones de fragmentos de texto de una versión antigua de otro conjunto de datos, de los cuales 23 millones eran propiedad de USA Today, publica Infobae.
Además, la acusación incorpora como pruebas declaraciones de un ejecutivo de OpenAI asegurando que el avance de la IA es una «amenaza existencial» para las publicaciones, a las que terminará por reemplazar, y de un ingeniero confesando que las respuestas de los bots de la compañía alejarían a los usuarios de las fuentes originales.
La doctrina del uso justo
Reuters señala que por el momento OpenAI no ha respondido ante tales acusaciones. No obstante, la compañía con sede en San Francisco ya ha defendido en causas similares que el empleo y procesamiento de materiales protegidos para entrenar a sus modelos está amparado por la doctrina del fair use o uso justo, argumentando que sus algoritmos transforman el contenido original en una creación nueva.
Más demandas a OpenAI y otros operadores
La de USA Today no es la primera demanda que se interpone contra OpenAI por vulnerar los derechos de autor. En estos momentos, la compañía de IA se enfrenta a acusaciones similares en un tribunal de Nueva York por parte de destacados escritores y medios de comunicación como el New York Times.
Otras tecnológicas de la competencia, como Meta o Anthropic, también están inmersas en procesos judiciales por presuntos usos indebidos de su contenido para el entrenamiento de sus modelos de lenguaje. En muchos de los casos, las compañías se han defendido apoyándose en el citado uso justo, que en la legislación estadounidense habilita para usar material protegido si la finalidad es transformarlo en algo nuevo, concluye Reuters.
Fuentes: Diario Constitucional, Infobae, Reuters.